Китай все більше покладається на імітацію американських технологій у сфері штучного інтелекту, — The Economist.
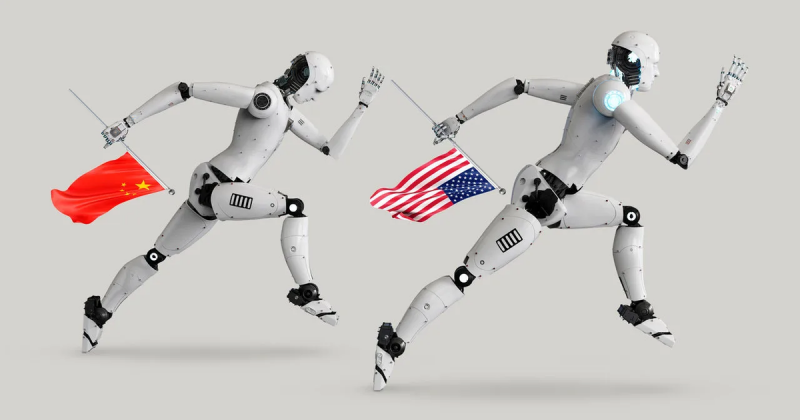
Китай швидко скорочує відставання від США в галузі штучного інтелекту, і значною мірою це відбувається завдяки зусиллям самих американців. Китайські фірми використовують дані та результати своїх американських конкурентів для навчання своїх моделей штучного інтелекту, що дозволяє їм значно економити ресурси. Хоча ця стратегія сприяє зменшенню прогалини, вона також може стати небезпечною: поки Китай зосереджений на наслідуванні іноземних досягнень, йому важче буде досягти лідерства. Про це інформує видання The Economist. Texty.org.ua пропонує детальний переклад статті.
Уявіть людину на водних лижах. Рухаючись на хвилі за швидкісним катером, вона часом може розвивати більшу швидкість, ніж судно, яке її тягне, але ніколи не зможе його обігнати. Останнім часом деякі експерти використовують цю аналогію, щоб описати суперництво Китаю та США за лідерство у сфері штучного інтелекту.
В їхньому розумінні, швидкий розвиток китайських лабораторій в значній мірі обумовлений тим, як оперативно їхні американські опоненти розширюють горизонти штучного інтелекту. Якщо США пришвидшать свої зусилля, Китай зможе так само активізувати свої розробки. Однак, у випадку сповільнення темпів у США, китайські інженери теж відчують наслідки цього уповільнення.
Причина полягає в процесі, відомому як "дистиляція" ШІ-моделей. Цей підхід передбачає навчання однієї моделі на основі відповідей іншої, замість того, щоб формувати її знання та навички з нуля. З розвитком штучного інтелекту все більше постає питання, наскільки інтенсивно китайські компанії використовують дистиляцію провідних американських моделей.
Американські підприємства зацікавлені в тому, щоб споживачі обирали їхні високоякісні продукти, а не вдавалися до недорогих аналогів. Одночасно США мають намір підтримувати свою конкурентну перевагу над Китаєм. Президент Дональд Трамп підкреслював: "Той, хто здобуде перемогу в галузі штучного інтелекту, стане переможцем у всьому".
Утім, масове використання дистиляції передових моделей може виявитися не таким шкідливим для США і не таким вигідним для Китаю, як здається на перший погляд.
Принцип дистиляції доволі простий. На початкових етапах навчання великі мовні моделі (LLM) зазвичай вчаться відтворювати закономірності текстів, зібраних в інтернеті. Натомість під час дистиляції їх навчають наслідувати інші мовні моделі.
Відповіді американських моделей відображають ті навички та аналітичні здібності, які китайські розробники прагнуть вдосконалити у своїх системах. Таким чином, ці відповіді набувають статусу цінного навчального ресурсу.
Американські фахівці, що займаються розробкою штучного інтелекту, не мають доступу до більш досконалих моделей, з яких могли б черпати досвід. Крім того, наявні в інтернеті матеріали як джерело нових навчальних даних майже вичерпалися. Внаслідок цього вони все частіше звертаються до менш ефективного з точки зору витрат методу — навчання з підкріпленням (reinforcement learning, RL).
Основна ідея полягає в тому, що моделям ставляться конкретні завдання, як от розв'язання складних математичних проблем, і їм надається можливість проводити експерименти, самостійно відшукуючи оптимальні рішення.
Нині американські компанії витрачають на методи, пов'язані з навчанням із підкріпленням, понад половину своїх обчислювальних ресурсів. На початку 2024 року ця частка становила лише близько 5%.
Китайські підприємства, у свою чергу, можуть використовувати дистиляцію для передачі своїм моделям навичок, які американські системи набули через витратне навчання з підкріпленням. Це нагадує випадок, коли один учень отримує допомогу від репетитора, а інший змушений самостійно шукати рішення. У результаті перший засвоює матеріал значно швидше.
Яскравим прикладом є експеримент, проведений китайською лабораторією DeepSeek. Невелику модель навчали на 800 тисячах даних, які були згенеровані найпотужнішою моделлю компанії. Як результат, її успішність у одному з популярних математичних тестів підвищилася з 14,6% до 45,8%. Ці результати були представлені в дослідженні, опублікованому в липні у збірнику Findings of the Association for Computational Linguistics.
Для того щоб реалізувати потенціал найсучасніших моделей, необхідно суттєво більше інформації. Проте китайські лабораторії, здається, вже активно застосовують дистиляцію в масштабах, що вражають.
Відповідно до інформації, наданої у звіті Anthropic, який вийшов у вересні, п'ять китайських компаній за короткий проміжок у п'ять місяців змогли зібрати більше 180 мільйонів повідомлень, створених їхніми моделями. Моделі з Китаю виявляють помітну схожість з американськими аналогами (див. графік), і часом навіть ідентифікуються під назвами Claude або ChatGPT.
Наскільки важлива дистиляція для розвитку китайського ШІ? Значна частина китайських досягнень у цій сфері -- результат власних розробок. Понад половину провідних дослідників штучного інтелекту у світі мають китайське походження, якщо оцінювати за науковими роботами, представленими на NeurIPS -- головній міжнародній конференції зі штучного інтелекту.
Але самих інтелектуальних ресурсів недостатньо. Сьогодні головним рушієм розвитку ШІ є передові комп'ютерні чипи. Кожен із найбільших американських технологічних гігантів має більше таких обчислювальних ресурсів, ніж усі їхні китайські конкуренти разом узяті.
Дистиляція відіграє важливу роль у вирівнюванні конкурентних можливостей китайських компаній. За даними досліджень, штучний інтелект у Китаї відстає від провідних американських систем приблизно на три до шести місяців. На думку Саїфа Хана з Вашингтонського Центру технологій і державного управління, без застосування дистиляції цей розрив міг би зрости майже вдвічі.
Anthropic та OpenAI прагнуть розірвати цей зв'язок. Компанії вжили заходів, щоб усунути виявлену в серпні вразливість, яка давала китайським розробникам доступ до проміжних міркувань їхніх моделей під час розв'язання завдань. Вони також посилили виявлення масового збору даних для дистиляції.
Anthropic почала брати плату за запити до Claude, навіть у випадках, коли модель виявляє спроби дистиляції і відмовляється надавати відповіді. Це означає, що навіть невдалі спроби отримати навчальні дані стають витратними.
Компанія усвідомлює, що нововведення можуть виявитися малоефективними у тривалій перспективі. Однак, на даний момент, їй вдалося зменшити обсяги даних, що збираються для дистиляції, на 90-99%. Внаслідок таких обмежень Anthropic може зазнати втрати близько 5-7% своїх доходів.
В компанії зазначають, що такі дії обумовлені тим, що китайські розробники створювали моделі, які за своїми характеристиками були близькі до найсучасніших, проте не мали належних механізмів захисту від зловживань. Anthropic вважає, що подібні потужні моделі можуть представляти загрозу для національної безпеки.
Проте, якщо американські лабораторії зможуть обмежити доступ конкурентів до своїх моделей, у майбутньому вони можуть пожалкувати про це.
Навіть самі китайські науковці висловлюють сумніви щодо того, чи є залежність від дистиляції оптимальною стратегією. Лише небагато з них вважають, що навчання на основі американських моделей є неетичним. Врешті-решт, розробники сучасних моделей також створювали свої системи, використовуючи дані, які були вільно доступні в мережі.
Однак деякі лідери китайських підприємств вважають, що залежність від дистиляції призведе до вічного другого місця для Китаю. Дослідники з китайських лабораторій також висловлюють думку, що в майбутньому рекурсивне самовдосконалення штучного інтелекту, яке передбачає самостійне створення більш досконалих моделей, вимагатиме складної інфраструктури, доступної лише для компаній, що не обмежуються лише дистиляцією.
У липні засновник китайської інтернет-компанії ByteDance Чжан Їмін повідомив працівникам, що компанія не планує застосовувати дистиляцію для покращення своїх моделей.
Китайське технологічне видання LatePost передало його думки наступним чином: дистиляція "в найкращому випадку дозволить нам систематично зменшувати відставання [від лідерів], але насправді обійти їх буде непросто".
Чжан вказав, що відмова від підходу, який з'єднує розвиток китайських розробників із успіхами американських компаній, призводить до зростання відставання ByteDance.
Проте, на відміну від певних китайських суперників, ByteDance володіє різноманітними джерелами прибутку. Це дозволяє компанії тимчасово використовувати менш розвинені моделі штучного інтелекту, поки вона займається досягненням технологічної незалежності.
У Сполучених Штатах дистиляція продовжує залишатися викликом, але, можливо, це на краще, ніж ситуація, коли китайські фірми самостійно досягнуть лідерства у сфері штучного інтелекту.
Крім того, зв'язок китайських моделей з американськими може спростити процес регулювання штучного інтелекту.
Досі команда Дональда Трампа не бажала призупиняти прогрес у сфері штучного інтелекту з метою підвищення його безпеки, оскільки існували побоювання, що це може створити перевагу для Китаю в конкурентній боротьбі.
Але якщо Китай справді нагадує воднолижника, якого тягне американський катер, він, можливо, не зможе обігнати його, навіть якщо той сповільнить рух.
Інші публікації

Популярне
У тренді